The Discovery Engine を支えるアーキテクチャ

本サイトの記事を、人間とAIが共同で執筆するためのシステム。
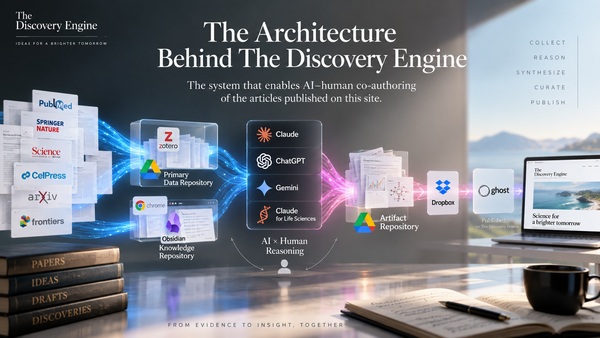
本サイトの記事はすべて、一人の人間と複数のAIシステムが協働して執筆しています。その仕組みを示したのが、この図です。
どのモデルを使うかは、一般に思われているほど重要ではありません。成果が十分な検証に耐えられるかどうかを左右するのは、文章や図などの素材がシステム内をどう流れるかです。どこから入り、何が何を変更でき、誰が判断を下し、完成した記事がどこに届くのか。この図は、そうした流れを描いています。共同執筆という特定の目的のために設計され、最終段階でも、すべての主張をその根拠となる証拠までたどれるアーキテクチャです。
本格的な科学研究に用いる Discovery Engine には、さらに幅広い機能が必要です。その一部は、今後、本サイトで公開するかもしれません。どのような機能が必要になるかは、本稿の最後で述べます。
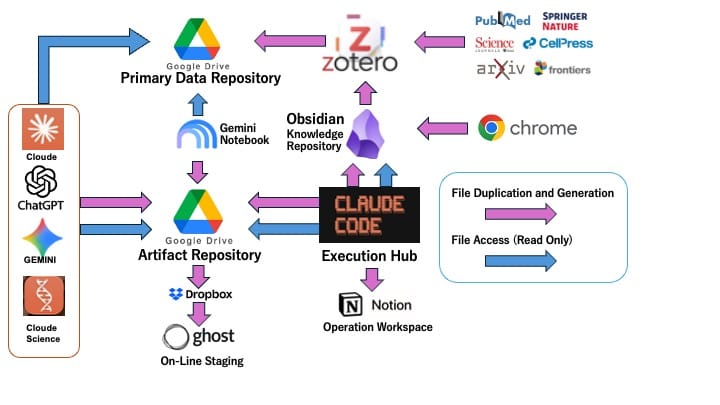
図1 The Discovery Engine を支えるアーキテクチャ。本サイトで公開する記事はすべて、図に示したワークフローで制作しています。図は2026年9月時点の構成を示したもので、今後も変化していく見込みです。AIで生成したものではなく、PowerPointを使い、手作業で描きました。AIが生成した図は、本稿の末尾に掲載しています。
まず矢印を読む
この仕組みを理解する鍵は、凡例にあります。
ピンクの矢印は、ファイルの複製と生成を表します。 新たなファイルを作成するか、既存のファイルを別の場所にコピーします。青い矢印は、読み取り専用のアクセスを表します。 各コンポーネントはファイルを参照できますが、変更はできません。
設計上のルールは、一つだけです。収集したファイルは、その保管場所では編集しない。 ソースを読み取る場所と、成果物を書き込む場所を分け、同じディレクトリには置きません。再現性の確保、来歴(プロヴェナンス)の追跡、各コンポーネントの交換のしやすさは、すべてこの一つの制約から生まれます。
個々の製品名の背後には、共通する一連の流れがあります。不変のソース → 生成された成果物 → キュレーションされた知識 → 公開。 図中のツールはどれも別のものに置き換えられますが、この順序は変えられません。
収集
図の右端は、外部の情報を取り込む入口です。PubMed、Springer Nature、Science、Cell Press、arXiv、Frontiers から、Zotero へと資料を集めます。Zotero が担うのは、PDFをメタデータとともに取り込むという、まさにその得意分野です。これにより、論文は s41586-024-07123-4.pdf という名前だけの孤立したファイルではなく、DOI、著者、日付の情報を伴う資料として取り込まれます。
次に、Zotero から Google Drive 上の Primary Data Repository(一次データリポジトリ) に資料を格納します。あえて二段階に分けているのは、Zotero を取り込みのためのツールと位置づけ、恒久的な保管場所とはしていないためです。一次データリポジトリに入った資料は、以後、変更しないものとして扱います。ここは証拠を保管する層です。記事中の主張は、ここにあるファイルまで根拠をたどれなければ、公開しません。
これと並行して、Chrome から Obsidian へ取り込む経路もあります。論文以外の情報、たとえばプレプリントをめぐるスレッド、研究室のウェブサイト、補足資料に埋もれた手法、学会抄録などを扱うためのものです。これらは文書ファイルとしてではなく、ノートとして Knowledge Repository(知識リポジトリ) に保存します。
二つのリポジトリ、二つの役割
一次データリポジトリと Obsidian は、それぞれ異なる種類の情報を保持しており、役割が重複しているわけではありません。
一次データリポジトリに保管するのは、内容が固定され、引用できる、未編集のソースです。一方、Obsidian に蓄積するのは、論文から読み取ったメカニズム、論文同士のつながり、検討を重ねている議論といった解釈です。ソースは引用の対象であり、解釈は自らの考えです。両者を別々のシステムで管理すれば、考えが変わっても、公開済みの記事を支える証拠が知らないうちに書き換わることはありません。
推論ベンチ
図の左側には、Claude、ChatGPT、Gemini、Claude for Life Sciences という複数のモデルが並んでいます。それらを取り巻く矢印は、この図で最も重要な部分です。
ただし、矢印だけでは、そこで行われていることを十分には表せません。推論ベンチから成果物リポジトリへ伸びる一本のピンクの線の背後には、通常、長いやりとりがあります。論文が実際に何を示したのかを著者とモデルで議論し、ある解釈に対する最も強い反論を求め、重要な区別を曖昧にしてしまった要約には修正を求めます。一度のやりとりで仕上がるものは、ほとんどありません。
モデル同士で互いの結論を検証させることもします。あるモデルが情報を統合してまとめたものを、同じソースとともに別のモデルに渡し、どこに問題があるかを問います。そこで生じる見解の違いが、役立つことも少なくありません。二つのモデルが同じ主張をそろって控えめに表現することは、めったにないからです。本稿もこの方法で作りました。あるシステムが草稿を書き、別のシステムが批評し、その批評を踏まえて改稿しています。
著者とモデルの対話も、モデル同士の議論も、図には描かれていません。どちらも、成果物として書き出す前の会話の中で行われるからです。図に現れるのは、保存されたものです。そこには完成品だけでなく、途中段階の素材も含まれます。情報の部分的な抽出結果、分析、プロット、図の下書き、ある推論を採用しなかった理由のメモなども、成果物リポジトリに保存します。
こうした中間素材を残すのは、意図した設計です。これにより、成果物リポジトリは共有作業記憶として機能します。あるモデルが残したものを、別のモデルや著者が引き継げるため、作成時のやりとりに参加していなくても、作業を続けられます。
つまり、このアーキテクチャは、1970年代のAI研究でいう「黒板システム」に当たります。互いに直接やりとりできない独立した専門家が、共通の情報構造を読み書きする仕組みです。誰か一人が指揮するのではなく、その情報構造の状態に応じて協調が生まれます。HEARSAY-II は、この方法で音声認識を行いました。ここでは、複数のモデルが同じ方法で文献を読み解きます。人間も、全体の上に立つ監督者ではなく、同じ黒板に書き込む参加者の一人です。
一次データリポジトリへの接続は、青で示されています。モデルは文献を読めますが、変更はできません。モデルの出力はピンクの矢印に沿って、Artifact Repository(成果物リポジトリ) へ送られます。これは Google Drive 上に別途設けた保管場所で、草稿、抽出結果、表、処理の記録、図など、生成されたものだけを保持します。
この仕組みによって、推論ベンチは特定のモデルに依存せずに機能します。どのモデルも同じ読み取り専用のコーパスを参照でき、それぞれの出力を互いに干渉することなく蓄積できます。モデルを入れ替えるたびに、文献ライブラリを作り直す必要はありません。
Gemini Notebook(NotebookLM) は、二つのリポジトリをつなぐ経路上で、資料に根拠を置いた情報の統合(grounded synthesis)を担います。モデルの一般知識ではなく、特定の文書群に基づく要約が必要なときに役立ちます。
実行ハブ
Claude Code は、双方向への書き込み権限を持つ唯一の自動化されたコンポーネントです。人間の著者は Obsidian に直接書き込み、Zotero は一次データリポジトリに資料を格納しますが、人間以外のプロセスで二方向への書き込みを許されているのは Claude Code だけです。その権限を認めているのは、文章の生成ではなく、コードの実行を担うからです。
Claude Code は成果物リポジトリを読み書きし、Obsidian にも書き戻します。この処理によって、生成された成果物は、単にフォルダに置かれたファイルから、知識ベースの恒久的な一部になります。コーパスの構築、来歴情報のタグ付け、引用の検証、図の生成など、繰り返し実行する手続きは、ここに集約しています。これらは会話に頼るのではなく、実行可能な手続きとして定義されており、再実行しても同じように動作します。
Notion は、Operation Workspace(運用ワークスペース)です。何が進行中で、何が行き詰まり、何が完了したのかを管理します。作業そのものではなく、作業の状況を記録する場所です。
公開
成果物リポジトリ内の素材は、Dropbox を経由して Ghost に送られ、オンラインのステージング環境に置かれます。収集、読解、生成、実行を経た素材を、公開前に確認するための段階です。
人間はどこにいるのか
この図には、「著者」と書かれた箱がありません。だからこそ、人間がどこに関わるのかを明確にしておく必要があります。共同執筆こそが、このアーキテクチャの目的だからです。
推論ベンチとの継続的なやりとりに加え、人間は仕組みの中で四つの役割を担っています。この四つが、記事の内容と方向性を決めます。
テーマの選定と収集。 そもそも何について書く価値があるのかを決め、関連する文献を最初に広く調べるのは、人間です。四つの役割のうち、AIが最も深く関わるのはこの段階です。調べる価値のある文献を提案し、キーワード検索では見落としていたかもしれない論文を見つけ、取得可能なファイルを集めます。ただし、AIが提示するのは候補であり、何を問うのかを決めるのは人間です。
選別。 収集によって集まった候補の中から、何を採用するかを決めます。一次データリポジトリに収めた資料が、証拠となります。こうして構築したコーパスは、単なる検索結果の集まりではなく、何が関連する資料なのかについての判断を反映したものです。
解釈。 Obsidian は、人間が自分の考えを書く場所です。モデルは情報の抽出、要約、相互参照を行えますが、一連の知見が何を意味するのか、どの論点をさらに追う価値があるのかは、著者自身の言葉でここに蓄積していきます。
公開ゲート。 Ghost に自動で送られるものはありません。ステージング環境を設けているのは、読者に届く前に、人間が内容を確認するためです。
この四つのいずれでも、AIが貢献し、人間が判断します。各段階の間では、扱う量が増えると人間だけでは対応しきれない作業をAIが担います。幅広い文献の読解、一貫した情報抽出、来歴情報のタグ付け、引用の検証、図の生成などです。この分担は、「AIが下書きし、人間が編集する」というものではありません。むしろ、その逆に近いといえます。人間が方向を定め、判断を担い、機械は、何百本もの論文を扱う場合でも人間がその役割を維持できるよう、作業を引き受けます。
四つの保管クラス
一見すると、この図はツールの一覧に見えます。しかし、いくつかのツールは複数の役割で登場しており、そこに意味があります。変わらないのは製品ではなく、それぞれの保管場所でファイルをどう扱うかというルールです。
- 変わらないもの(Immutable)。 一次データリポジトリが該当します。収集時に一度だけ書き込み、すべてのコンポーネントから参照できますが、どのコンポーネントも変更できません。
- 生成されたもの(Generated)。 成果物リポジトリが該当します。推論ベンチと実行ハブが書き込みます。ここにある生成物を、正しさの根拠となる情報源として扱うことはありません。
- キュレーションされたもの(Curated)。 Obsidian が該当します。著者と Claude Code が書き込みます。解釈を蓄積する場所は、ここだけです。
- 運用のためのもの(Operational)。 Notion、Dropbox、Ghost が該当します。作業の調整と配信を担い、情報の流れの下流に位置します。
図に Google Drive が二度登場するのは、Google Drive そのものが一つの層を構成しているわけではないからです。層を分けるのは、「変わらないもの」と「生成されたもの」という役割です。このようにアーキテクチャを定義すれば、利用する製品は自由に選べます。それこそが、この設計で求めている性質です。
研究のための Discovery Engine へ
このアーキテクチャが支えるのは、記事の共同執筆です。科学研究を目指す Discovery Engine には、さらにいくつかの機能が必要になります。それらは、ここまでの構造を置き換えるものではなく、そこに加えるものです。以下に、必要となる機能を挙げます。
実験データ層。 現在の仕組みでは、公開された文献が証拠の層を構成しています。研究のためのエンジンには、それに加えて、自ら取得した一次観測データが必要です。装置が出力する生データを、後から再構成するのではなく、取り込み時に標準化します。これにより、スペクトルやリードカウントを、取得条件のパラメータとともに最初からシステムに取り込めます。既存の保管領域と並行して、はるかに大規模な、第二の不変データ保管領域を設けることになります。
物理的実行層。 Claude Code がファイルを対象に処理を実行するのに対し、研究では物質を対象とする操作も必要です。リキッドハンドラー、自動イメージング装置、プレートリーダー、シーケンサーなどがそれに当たります。ロボティクスは、第二の実行ハブとして図に加わります。そこから得られるのは生成物ではなく測定値であり、生じる不具合も、計算上のものではなく物理的なものになります。
推論と実行の間の設計層。 現在のパイプラインでは、推論ベンチが生み出すのは草稿です。研究のパイプラインでは、実験プロトコルを生み出す必要があります。対照条件と反復の構成を備え、自動化プラットフォームが受け付けて実行できる実験計画です。執筆にはこれに相当する段階がないため、現在の構成には、この役割を担う層がありません。
戻りの経路。 これだけは、単なる機能の追加ではなく、構造そのものの変更です。現在のパイプラインは一方向に流れ、公開で終わります。記事は公開によって完成するので、それで問題ありません。しかし、研究はそこで終わりません。測定値を解釈の段階へ戻し、その測定につながった仮説を修正する必要があります。この経路がなければ、ロボティクスを導入してデータの取得が速くなっても、理解が深まる速度は上がりません。
これらの機能の一部は、今後、本サイトで公開するかもしれません。
そのまま引き継ぐべきものは、設計上の原則です。ソースを変更せずに保持すること、生成物をソースとは分けて保管すること、そして、どの段階でも来歴をたどれること。記事を公開するシステムであれば、こうした原則は小さなコストで確立できます。しかし、実験を実行するシステムに後から組み込もうとすると、大きなコストがかかります。
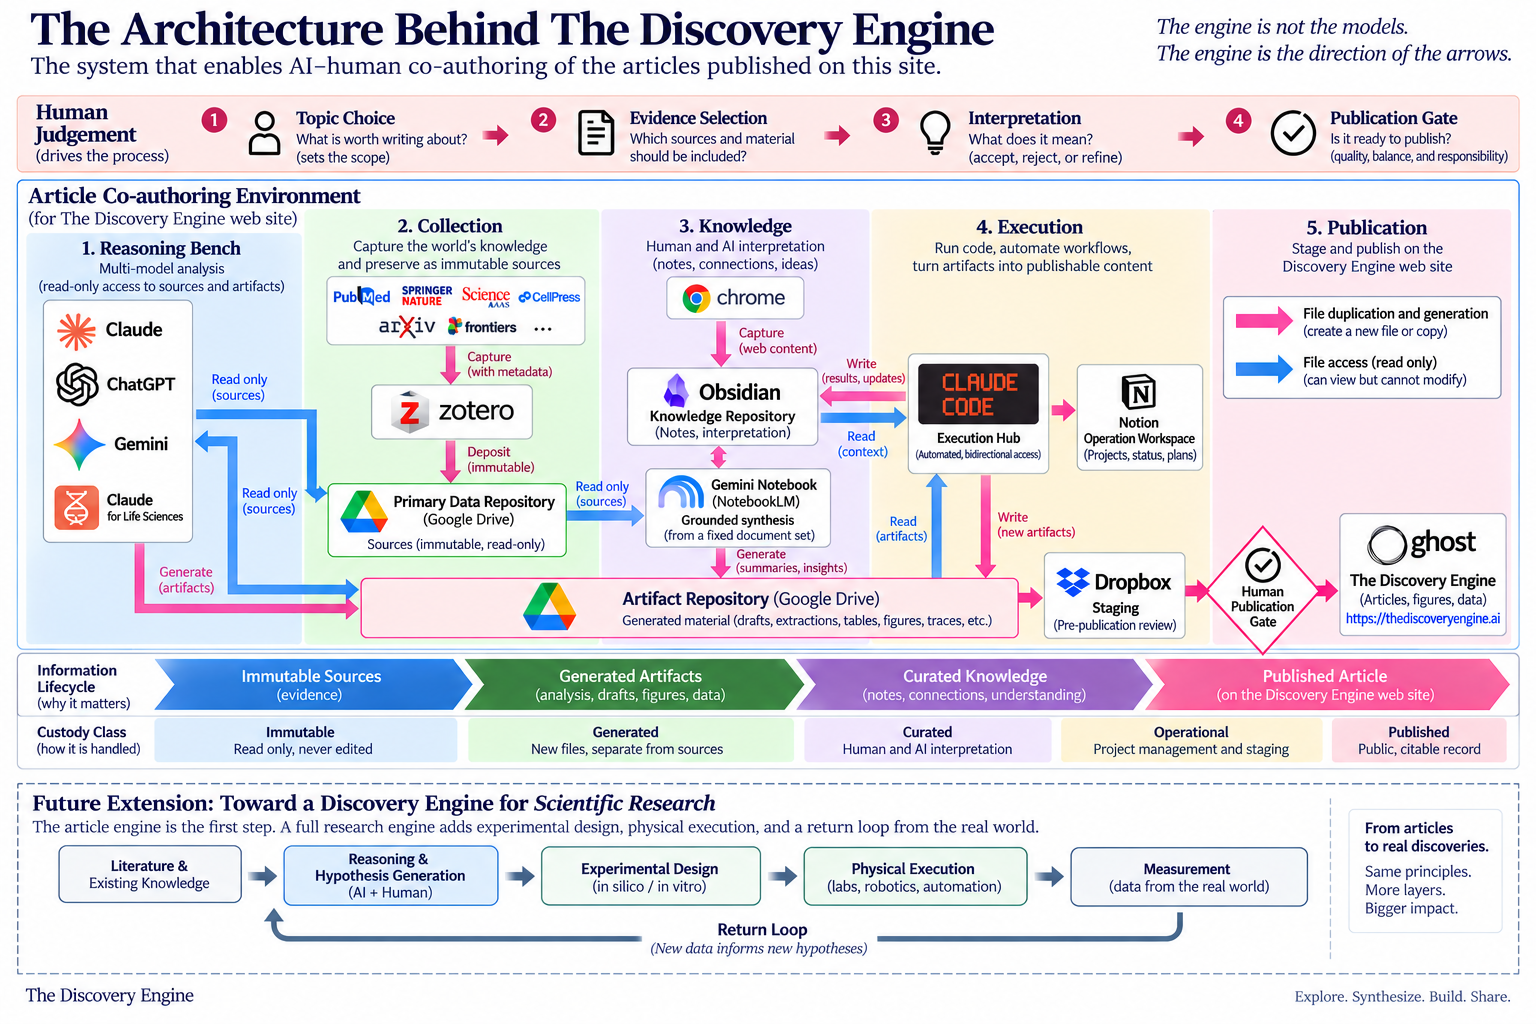
図2 本稿での議論をまとめた The Discovery Engine のアーキテクチャ(ChatGPTにより生成)
Discovery Engine の本質は、AIモデルそのものにはありません。その本質は、情報がどのように流れ、知識がどのように形成されるかを決めるアーキテクチャにあります。